
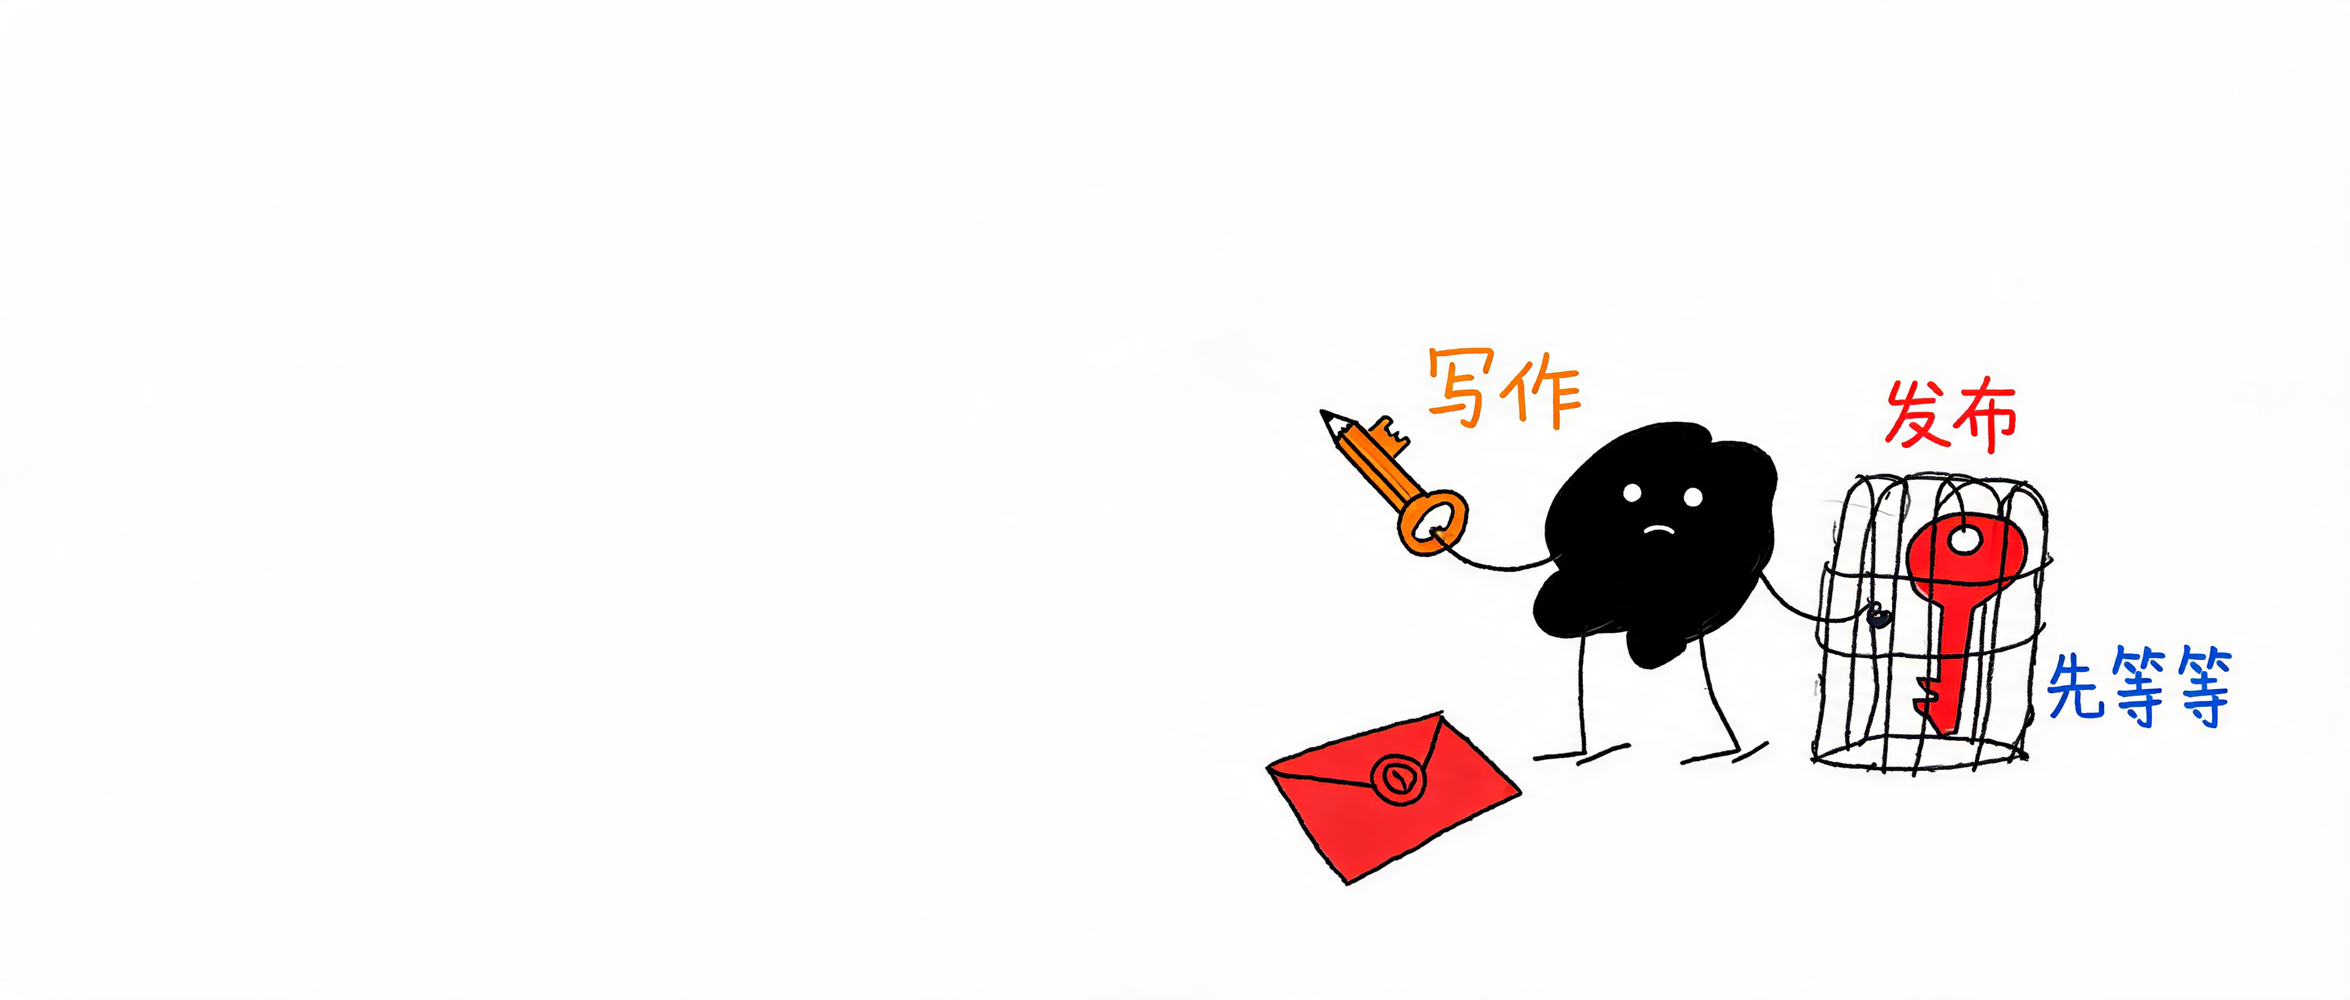
我把公开、低敏的日常写作交给了一个更便宜的模型,同时拿掉了它所有的外部工具权限,也收回了发布权。
这两个动作看起来有点拧巴:既然决定让 AI 帮忙,为什么不干脆让它从找材料一路做到发出去?
我以前确实很容易被这种“一站式”吸引。一个入口,一句话,后面的事情全自动完成,人只等结果就好。它省掉了中间的交接,也省掉了很多看起来麻烦的确认。
但其实,能力都堆在同一个地方,责任也会一起变模糊。写的人能直接发布,发布的人还能临时改稿,最后一旦需要停下来,就很难说清究竟该在哪一步踩刹车。更麻烦的是,“程序已经结束”和“真实世界里确实完成了”本来就是两件事,界面上的一个成功提示,不能替代最后的回读。
权限这件事平时很安静,只有出问题时才突然显得重要。模型写得不好,人还可以退回草稿慢慢改;模型如果同时握着发布权,人可能连重新判断的空隙都没有。表面上都叫自动化,实际承担的后果并不一样:前者还是内部过程,后者已经成了公开表达。
所以我现在把研究、写作和发布拆成互不重叠的三段。
一篇日常稿走到写作阶段时,模型面前只有已经整理好的公开低敏材料和写作要求。它看不到账号,没有外部工具,也碰不到发布入口;它交回来的只是一份稿子,不是“任务已经完成”的结论。
稿子经过验收,才会进入下一段。发布执行者拿到的是已经确认的终稿,只能照稿行动,不允许顺手改字。系统怎么设计、哪些判断不能外包、终稿到底能不能放出去,这些仍然由我自己负责。多一次交接确实没有一键到底那么顺滑,但它留下了一个很清楚的停点:稿子还没有公开,我仍然可以说“先等等”。
这不是为了把流程做得更像流程,而是把每一种错误尽量留在它该停下的地方。
我并不反对工具变得更强。一个工具能做什么,和我在一次具体任务里应该允许它做什么,是两回事。尤其涉及公开表达,我更愿意按需要给权限,而不是因为功能存在,就默认把整串钥匙都交出去。
我也把另一批事情从模型手里收了回来。日常提醒、授权失效告警这类有明确状态的问题,现在交给本地消息网关和确定性脚本。采集授权是否失效,由脚本按规则判断;提醒是否真的送到,要看真实送达回执,不能再拿调度进程正常退出当成业务已经完成。 这样一分,模型反而轻松了。它不需要假装知道系统此刻是什么状态,只需要处理判断、取舍和表达。脚本也不用理解一篇文章好不好,它只回答那些有确定标准的问题。两边都没有变得更全能,但各自少做了不擅长的事。
我现在理解的“降本”,也因此变了。
便宜模型当然能省下一部分调用成本,可那只是账单上最容易看见的一行。真正决定长期成本的,是任务有没有边界,结果有没有检查,失败时能不能及时停下,以及完成之后有没有真实回读。少了这些,一站式的便利只是把核对工作藏到了后面;一旦出问题,省下来的交接很可能又会变成更难追的返工。
当然,也不是每一张草稿都值得过三道门。
如果只是一次性的探索,写完不满意随时可以丢掉,完整门禁可能比错误本身还贵。这个时候,快一点、松一点没有问题。可一旦内容要正式对外,写作权和发布权就不该默认绑在一起。草稿里的错误还可以删除,已经越过发布口的内容,承担后果的人还是自己。
对普通创作者来说,这件事并不遥远。现在很多工具都在追求“一句话生成,一键发布”,看上去少点了几次鼠标,实际上也少了几次让人重新判断的机会。把权限拆开,不是拒绝自动化,而是保留在公开之前说“先等等”的能力。
我原来更关心模型能不能把整条链路都接过去。现在我更在意的是,它该在哪里停下,我又必须在哪里出现。
模型可以负责写,脚本可以负责确认状态,发布动作也可以继续自动化。只是最后那道判断,我不准备再和便利一起交出去。
读者讨论
评论
欢迎补充经验、提出问题或指出遗漏。所有新评论会先经过人工审核。
为了减少垃圾信息,仅支持 Google 账号登录后评论。
公开页面只显示你的名称和评论,不显示邮箱。